FIELD NOTE
ComfyUI 工具箱下篇:OpenAI 兼容 API、Web 界面与局部重绘排障
把本机 ComfyUI 包装成 OpenAI Images API,工具箱从桌面搬进浏览器,并修掉一个让局部重绘几乎失效的关键缺陷:涂抹区差异 3.71 到 113.70 的完整排障过程。
字号
文章字号:当前标准档正文宽度
上篇记到四类工作流全部跑通、桌面工具箱能出图为止。这篇是下篇,覆盖之后的事:把 ComfyUI 包装成任何 Agent 框架都能调的 OpenAI 兼容接口,给工具箱换上浏览器界面,顺带挖出并修掉了一个会让局部重绘几乎失效的关键缺陷。照旧,所有结论都在那台 RTX 5060 Laptop 8GB 上实测。
这一阶段结束时,工具箱从「双击图标出图的桌面程序」变成了「一个端口、三套入口」:浏览器界面、OpenAI API、已退役但可救回的桌面版。中间最有价值的部分是局部重绘的排障过程,放在中间章节细说。
OpenAI 兼容 API:让程序把本机当成普通图像模型
目标是任何会说 OpenAI 协议的客户端——openai-python、LangChain、Dify 这类——都能把本机 ComfyUI 当成一个普通图像模型用,不需要了解节点、显存和采样器。
实现守着三条原则:
| 原则 | 做法 | 为什么 |
|---|---|---|
| 零新增依赖 | 只用 ComfyUI venv 里已有的 aiohttp / Pillow | 不 pip install,绝不碰刚升级好的环境 |
| 单一事实来源 | 直接 import comfy_core.build_workflow | Web、API、旧 GUI 共用一套工作流构造 |
| 默认不改写提示词 | prompt 原样生效,要改写需显式开启 | 符合 OpenAI 语义,接口不偷偷加工输入 |
对外只有三个核心端点:/v1/images/generations(文生图)、/v1/images/edits(改图、合成、去背景、局部重绘)、/v1/models(模型列表)。一共暴露 20 个模型名,其中大半是兼容别名:
| 模型名 | 实际行为 |
|---|---|
| qwen-image-2.1 / -t2i | 文生图 |
| qwen-image-2.1-edit | 改图 / 多图合成 |
| qwen-image-2.1-inpaint | 别名:等价于 -edit 加 mask 参数 |
| qwen-image-2.1-remove-bg / -bg-remove | 别名:等价于 -edit 加固定指令,输出 RGBA |
| dall-e-3 / dall-e-2 / gpt-image-1 | 兼容旧代码的别名,全部指向文生图 |
老代码里写 dall-e-3 也能直接换成这套后端,不用改一行。
size 参数的真实语义
这是实测里最有用的一个发现:size 在文生图和改图里的语义完全不同。
| 场景 | 请求 | 实际输出 | 结论 |
|---|---|---|---|
| 文生图 | 1000x700 | 1008×704 | 先做 16 像素对齐,静默取整 |
| 文生图 | 128x128 | HTTP 400 | 越界直接报错,不钳制 |
| 改图(1:1 输入) | 1536x1024(3:2) | 1248×1248 | 比例仍是 1:1,请求的 3:2 被忽略 |
| 改图(3:2 输入) | 1024x1024(1:1) | 1248×832 | 比例仍是 3:2,请求的 1:1 被忽略 |
| 改图(多参考图) | auto | 取第 1 张的比例 | 3:2 在前 → 896×608 |
也就是说:改图的输出比例由输入图硬性决定,size 只决定像素面积。想改比例,先改输入图。这个行为和 OpenAI 官方语义并不完全一致,但底层模型就是按输入分辨率工作的,硬掰只会更慢。
其他参数走常规映射:quality 映射到采样步数(low=15、standard=25、hd=40),n 收敛到 1~4 并在返回的 _meta.warnings 里说明,steps 和 seed 作为扩展字段透传。
并发:排队而不是失败
8GB 显存同时只能容纳一个任务,所以并发请求用信号量排队。实测两个请求同时发出,墙钟耗时约等于两者执行时间之和,没有重叠。有个容易写错的断言细节:客户端耗时里含排队等待,两个 client 时间相加会重复计数——我第一版测试就栽在这里。
实现过程中修掉的坑
挑几个有代表性的:
| 问题 | 表现与修法 |
|---|---|
| aiohttp 默认请求体上限 1 MiB | 一张 2.26 MB 的照片直接 413。真实照片普遍超过 1 MiB,放宽到 64 MiB |
| 鉴权漏了 /v1/models | 只在生成端点加了检查,模型列表无密钥可访问。改成中间件统一拦截 |
| 无 alpha 通道的 mask 静默失效 | ComfyUI 的 LoadImage 在无 alpha 时返回全零 mask,接口照常 200 但什么都不改。入口处显式校验 |
| 测试自己污染了测试环境 | 测试上传的中间文件落进参考图目录被当成基准图,断言失真。改为测试自建基准数据 |
Web 工具箱:界面不重复实现任何出图逻辑
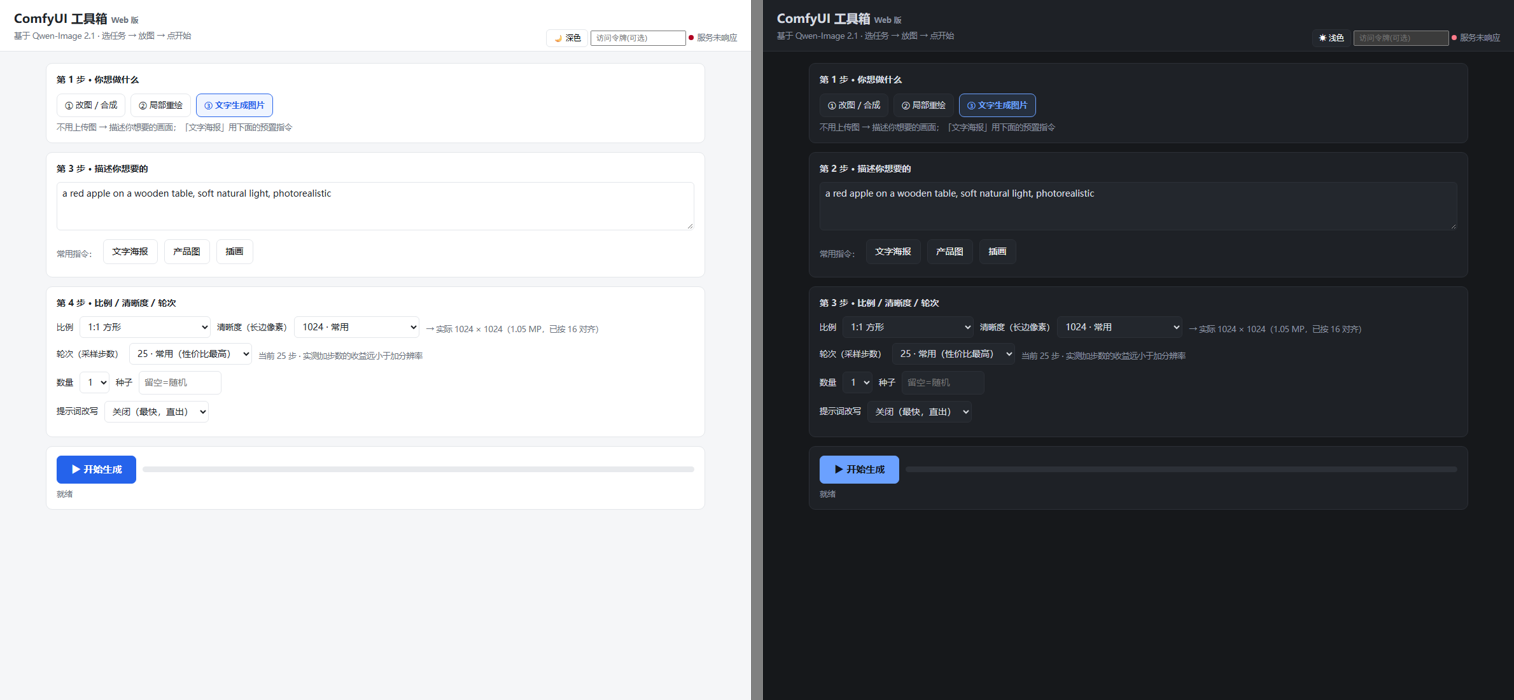
浏览器界面和 API 是同一个进程、同一个端口(默认 8010),双击 start_api.bat 自动打开浏览器。
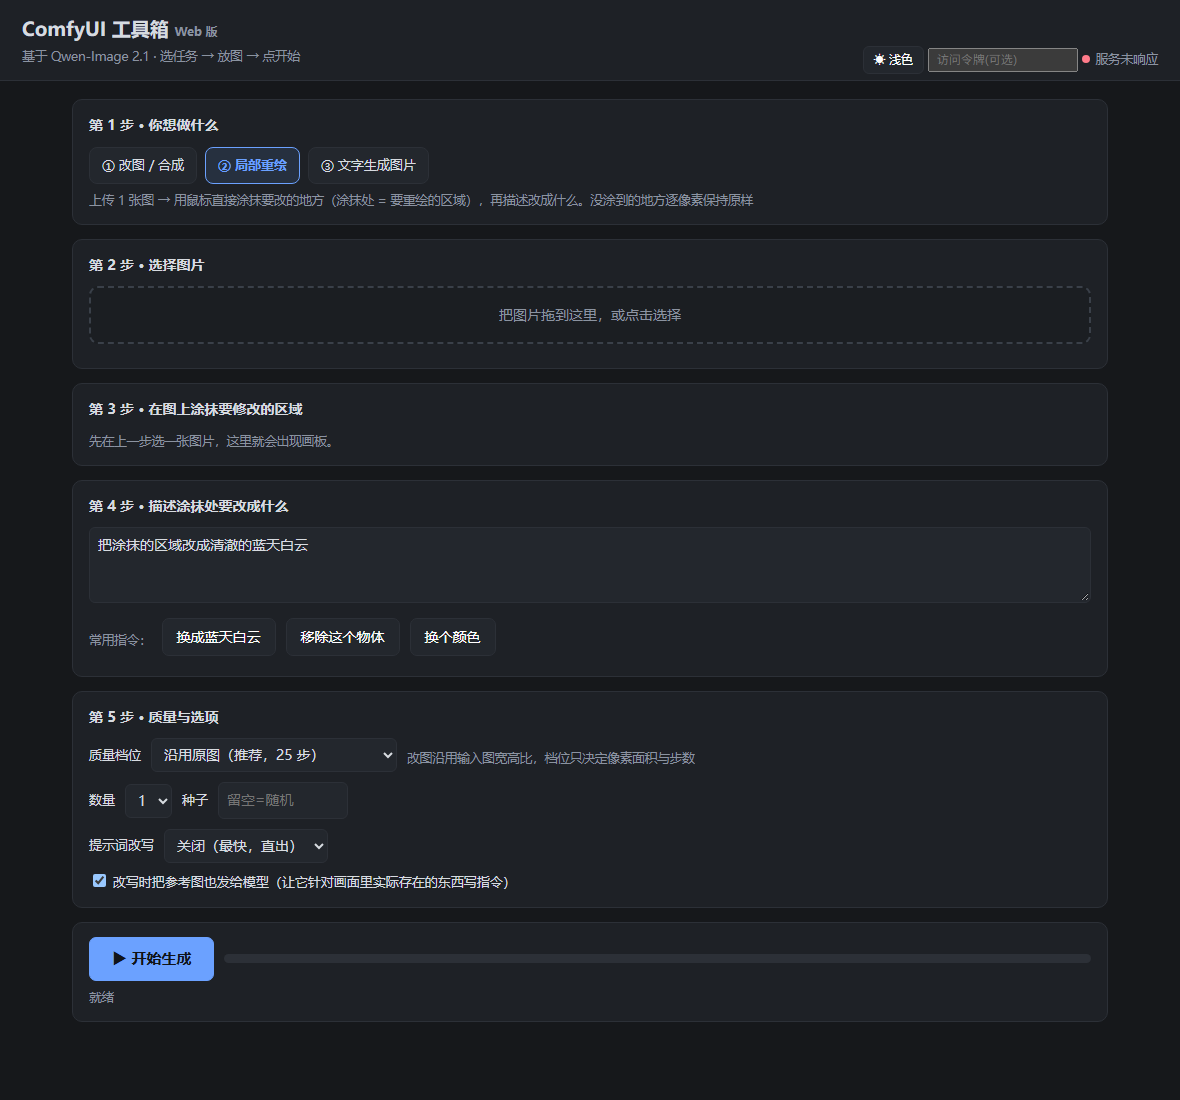
设计上有一条很省心的原则:界面调的是本服务自己的 OpenAI 接口。所以界面能出的图 = API 能出的图,不存在两套行为,界面每次使用顺带也在验证 API 本身。浏览器需要的额外通道只有两条:页面本身,和一条 SSE 通道把 ComfyUI 的实时进度转发给界面。
界面上新做的能力:
| 能力 | 说明 |
|---|---|
| 拖拽上传 | 图片直接拖进页面 |
| 真实进度条 | 经 SSE 转发 ComfyUI 的逐步进度,不是假装转圈 |
| 局部重绘 | 鼠标直接在图上涂抹,含橡皮 / 撤销 / 羽化 / 重绘强度 |
| 比例 / 清晰度 / 轮次 | 文生图三项独立可调,实时显示换算后的真实尺寸 |
| 深色模式 | 默认跟随系统,选择记忆在本地 |
| 局域网可用 | 设 COMFY_API_HOST=0.0.0.0 后手机、平板连同一网络即可用 |
SSE 通道在后端没起来时也不会放弃:持续发心跳并每 2 秒重试,后端一就绪进度立刻接上。实测「先开页面、后启动后端」的场景:触发一次出图后后端被自动拉起(端到端 36.6 秒),SSE 完整收到 1/8 到 8/8 八条进度事件。没有这个重试逻辑,这种启动顺序就永远收不到进度。
涂抹交互的一个前端坑
局部重绘的视觉反馈用半透明荧光笔:底图始终看得清,不挡正在涂的细节。但有个反直觉的地方——显示时的半透明和导出的 mask 必须是两回事。mask 导出靠 destination-out 消耗笔迹的 alpha,如果笔迹本身只有 0.85 的不透明度,导出的 mask 就是半透明的,服务端只会做部分重绘,涂抹处几乎纹丝不动。所以半透明只在显示时用 globalAlpha 合成,内部画布上的笔迹必须完全不透明。
文生图拆成三个独立控件
以前是尺寸和步数绑死的「质量档位」,现在拆成比例、清晰度、轮次三项。清晰度按长边像素给(768 到 2048),短边由比例推出,换比例时清晰度不用重调,界面实时显示算出的尺寸(如「实际 1024 × 576,已按 16 对齐」)。这些换算做过端到端抽验:前端算出的宽高原样到达服务端,输出一致。
深色模式不是把背景涂黑
纯黑配纯白反而更刺眼。深色主题的取值:
| 项 | 取值 | 说明 |
|---|---|---|
| 底色 | #16181b | 不是纯黑 |
| 正文 | #d7dbe0 | 不是纯白,减少眩光 |
| 强调色 | #6ba1ff | 浅色主题的 #2563eb 在深底上偏暗 |
两套主题的对比度都按 WCAG AA 验过,六组文字组合全部高于 4.5:1 门槛(正文对底色浅色 14.6:1、深色 12.8:1)。顺带修了一个先前就存在的问题:浅色主题的警告文字原本只有 4.36:1,低于门槛,调深一档解决。
局部重绘的三个关键发现
这是本阶段最重要的部分。
第一:必须去掉「原图参考条件」
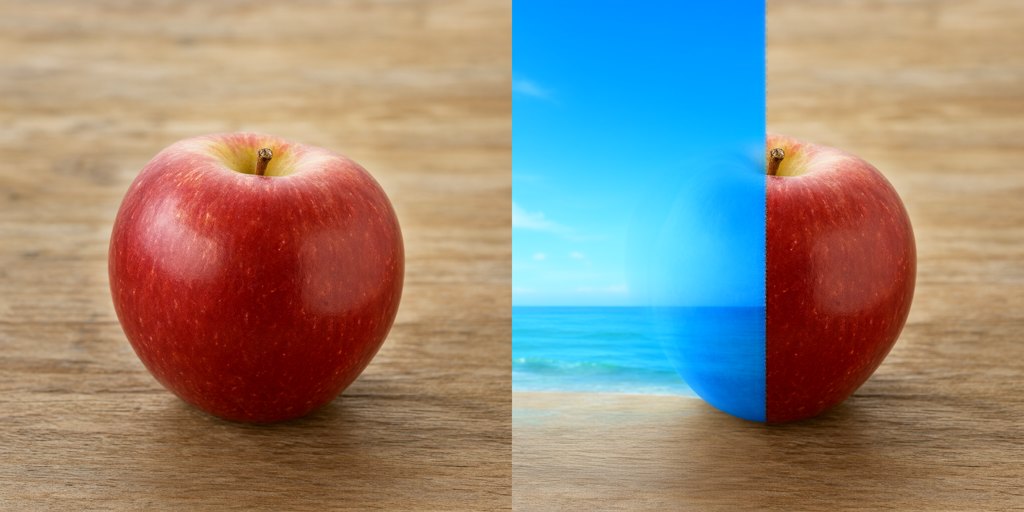
改图流程会把原图作为参考图接进 TextEncodeQwenImage21,这对整图改图是对的。但局部重绘时,它会让模型把原主体一直画回来——你涂了半天那块区域,模型坚持「这里是个苹果」。
同一张图、同一种子、同一个涂抹区、同一句提示词,只改这一个条件:
| 编码器是否带原图参考 | 涂抹区差异 | 涂抹区外差异 |
|---|---|---|
| 带(原本的行为) | 3.71 / 255 | 0.46 / 255 |
| 不带(现在的行为) | 113.70 / 255 | 0.47 / 255 |
33 倍差距,而涂抹区外一样保持原样。所以带 mask 时会传 no_ref_cond=True:原图仍走 LoadImage 和 VAEEncode,但不接进文本编码器。画面上下文并不缺——未遮罩区每一步都被钉在原始 latent 上。
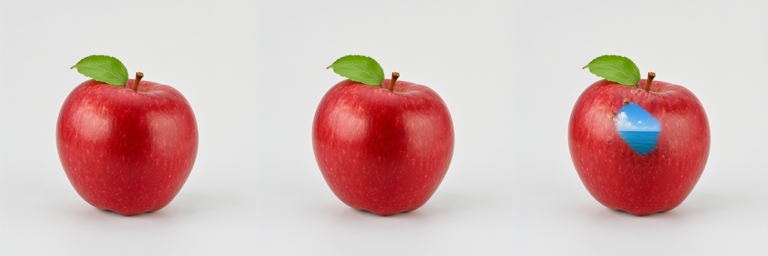
这个问题差点被我漏掉。最初用「中央小圆」做测试,只看到「几乎没变」,差点当成「小面积遮罩本来就不行」。把同尺寸的圆挪到背景上一试,差异立刻变成 31.8——说明不是面积问题,而是「涂在主体上」才失效,这才逼出真正的变量。之前也排除过两个猜想:换 4 种提示词写法没用(差异 3.7~5.7),cfg 从 1.0 提到 3.0 也没用(3.50 / 3.59 / 3.72)。
第二:mask_denoise 有个很陡的阈值
| mask_denoise | 20 步 | 60 步 | 100 步 | 实际变化 |
|---|---|---|---|---|
| 0.5 | 2.17 | — | — | 几乎不动 |
| 0.85 | 2.35 | 2.13 | 2.06 | 几乎不动 |
| 0.9 | — | 8.41 | — | 只改一点 |
| 1.0(默认) | — | 96.95 | — | 完整重绘 |
0.85 以下那 2.1 的差异值就是 VAE 往返噪声底,等于什么都没改。更重要的是加步数救不回来——20、60、100 步都试过,不是步数预算问题。这个阈值比直觉陡得多,参数必须贴着 1.0 用。
第三:边缘羽化和遮罩外回贴
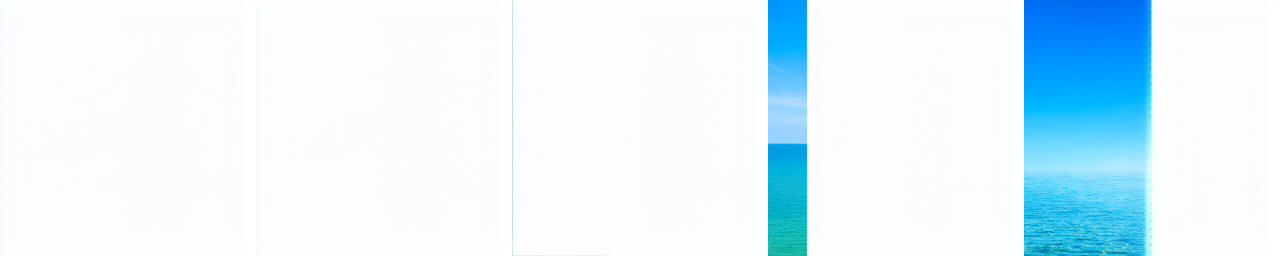
矩形硬边 mask 会在边界留下一条直缝。加羽化后,边界处的单列梯度峰值从 7.621.6 降到 4.9,峰值位置也从紧贴边界移开 21 列,视觉上就是软过渡。真实使用建议羽化 1224。
真 inpainting 已经把未遮罩区钉在原始 latent 上,但经过 VAE 编解码一个来回,像素级仍有细微偏差。所以默认再做一次「遮罩外回贴原图」,遮罩外差异从 2.25 降到 0.000。
光验证「遮罩外没变」是不够的——回贴自己就能做到零差异。真正的判据是:不回贴的前提下遮罩外仍然不变(2.25 ≈ VAE 往返误差),且把 mask 反转后两侧角色干净地对调(左 107.3 / 右 2.3 变成 左 2.3 / 右 98.9)。这招「反转对照」比找另一张图做对照组稳得多。
改写模型:切到 Agnes 3.0 Flash
上篇对比过的本地 9B 改写器(每张约 6 分钟)在 Web 版里退役了,改写任务交给外部 LLM,做了提供方抽象,用环境变量 PE_PROVIDER 切换:
| 提供方 | 模型 | 费用 | 改写耗时 |
|---|---|---|---|
| agnes(默认) | agnes-3.0-flash | 限时免费 | 中位 17 |
| deepseek | deepseek-chat | 约 0.002 元/次 | 中位 2~4 秒 |
代价很明确:免费换来约 5 倍延迟和更大波动。出图本身 30 秒不变,端到端从约 34 秒变成约 40 秒,能接受。
网络链路也有讲究。Agnes 的接口直连会 TLS 中断,必须经本地代理,但直连一旦偶发失败退回代理,后续请求就被钉在慢线路上(实测直连 5.5 秒,代理 16~29 秒)。最终策略是「直连永远优先、代理只做兜底」:先试直连,失败才探测常见代理端口,缓存线路给 3 次重试,单次成功率约 85%,重试后约 99.7%。这个「可用线路缓存后优先使用」的反模式值得记一笔——缓存的是线路,钉死的却是延迟。
看图改写:把参考图一并交给模型
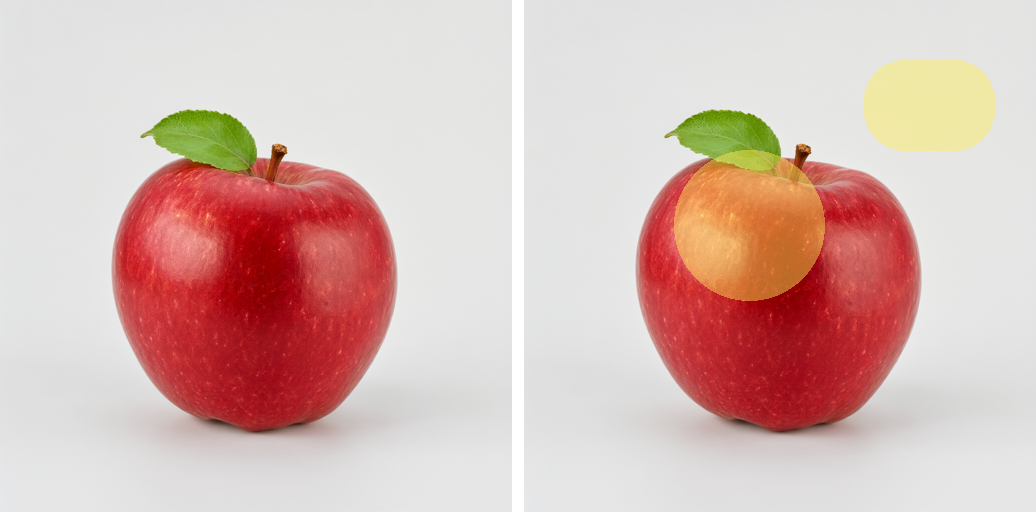
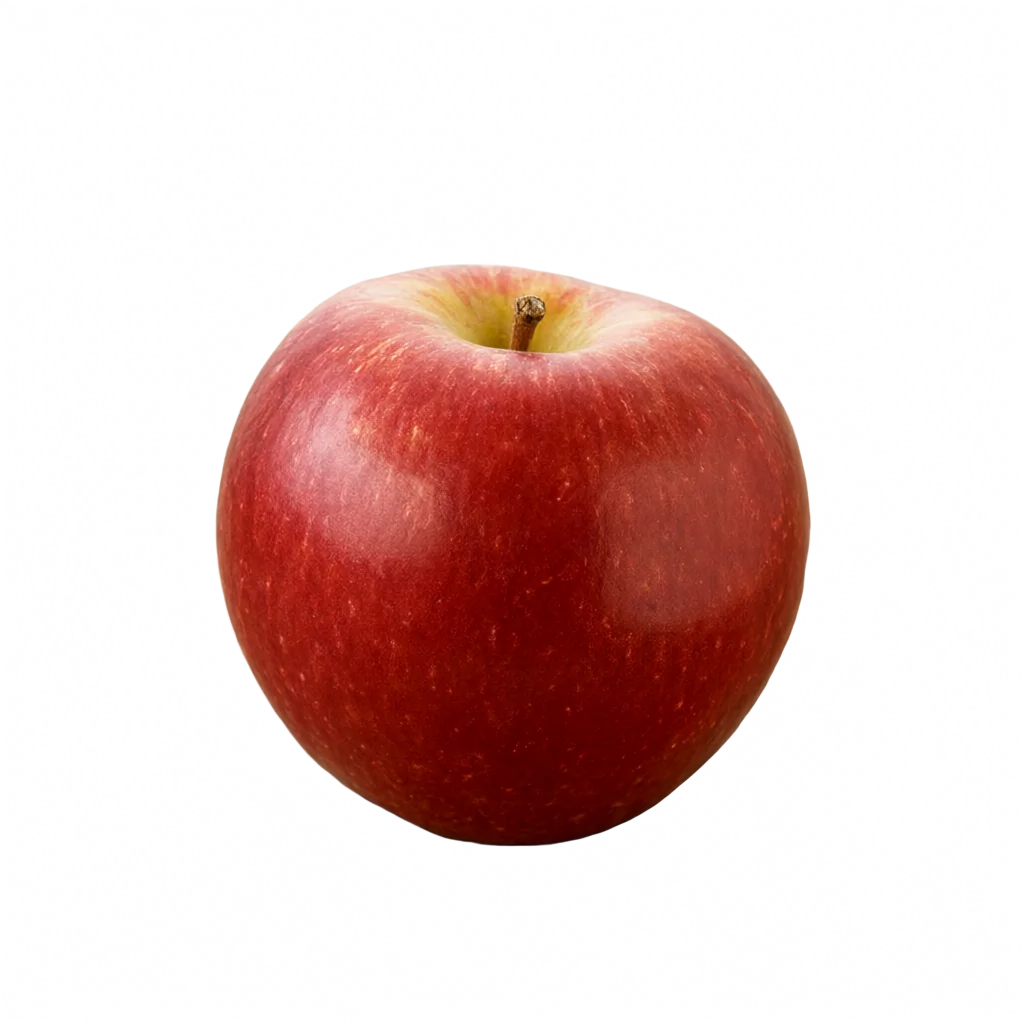
改图任务里用户往往只说「把背景换成深红色渐变」。改写器看不到画面,只能猜。Agnes 支持图像输入,于是改图时把参考图一起送进去。同一句话、同一张图(浅灰背景上的红苹果):
| 改写时 | 改写结果 |
|---|---|
| 不看图 | 「保持前景中所有人物、物体、文字和装饰元素……完全不变」——在猜 |
| 看图 | 「位于苹果后方的浅灰白纯色背景……保持顶部绿色叶片与棕色果梗细节完全不变」——看见了 |
局部重绘时更进一步:发给改写模型的是底图加荧光笔标记的渲染图,并附一句说明「半透明黄色高亮 = 要改的区域」。模型连荧光笔的颜色都看出来了,改写结果精确到「苹果正中央、绿色叶片与棕色果柄正下方的那个浅黄色圆形色块」。
实现细节:传图用 image_url 加 data URI(官方文档只写了公开 URL,实测 data URI 可用);图片先压缩到 768 长边转 JPEG,同一张图 1352 KB 缩到 58 KB,图像 token 从 1024 降到 576;最多附 3 张;提供方不支持视觉时(如 DeepSeek)自动退回纯文本,不报错。
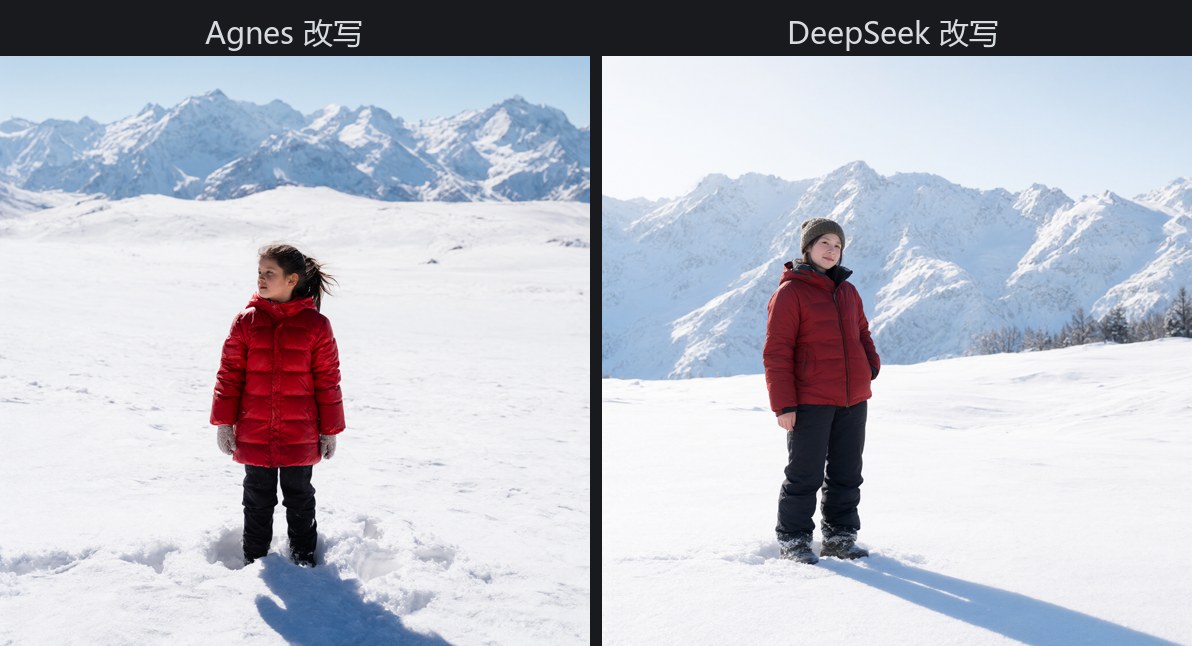
至于改写质量,同一种子同 25 步对比过 Agnes 和 DeepSeek:两者都准确还原了「雪山 + 雪地 + 阳光 + 红衣女孩」,Agnes 的成片饱和度更高、构图更宽,DeepSeek 加了针织帽、色调更柔。单样本不能断言谁更好,只能说免费的 Agnes 不拖后腿。
任务合并:4 个板块收敛到 3 个
实测发现两个「独立任务」其实是同一件事:
- 去背景和改图:两者产出的工作流 JSON 逐字节相同(只差输出文件名前缀),输出像素完全一致。去背景降级为「改图 + 一句固定指令」的兼容别名。
- 文字海报和文生图:走的是同一个代码分支,只是默认提示词强调「要出现的文字」。海报降级为文生图里的一键预置指令。
能力没有丢:界面在改图里提供一键指令(去背景 / 换背景 / 改画面文字),API 保留模型名别名,老代码不用改。最终只剩三个板块:改图/合成、局部重绘、文字生成图片。
这里的等价性判断是有纪律的:先确认两者工作流逐字节相同,再比对输出像素,最后才敢合并。判断「像素一致」而不是「字节一致」——PNG 里嵌的工作流元数据含输出文件名,那是无关紧要的差异,不该让断言变脆。
桌面 GUI 退役:拆出 comfy_core.py
桌面版(Tkinter)在 Web 版面前退役,但它不能直接删——API 依赖里面的工作流构造和后端管理。所以先拆分:
| 文件 | 内容 |
|---|---|
| comfy_core.py(新) | 工作流构造 + 任务定义 + 质量档位 + 后端管理,全入口共用的唯一事实来源 |
| legacy/comfy_toolbox.py | 只剩界面代码,从 core 导入 |
拆分后验证过 core 不再拖入 tkinter(import 之后 sys.modules 里没有它),4 个任务的工作流结构正确。桌面版唯一不可替代的能力是「本地 9B 改写器」档位——完全离线,约 6 分钟一张。其余功能 Web 版都覆盖且更好,不值得维护两个界面。
测试怎么兜底
这套东西改起来很凶,全靠测试兜住:
| 套件 | 覆盖内容 | 结果 |
|---|---|---|
| test_openai_api.py --full | 契约 / 出图 / 尺寸映射 / 真 inpainting / 看图改写(69 项子检查) | 72 / 72 |
| test_openai_api.py --token | 鉴权(含免鉴权路径) | 19 / 19 |
| test_toolbox.py | 核心工作流结构 + 真实提交给 ComfyUI | success |
| openai_client_demo.py | 官方 openai SDK 七个场景(含局部重绘) | 7 / 7 |
| 对比度检查 | 两套主题 × 六组文字组合 | 全部 ≥ 4.5:1 |
测试设计上有三条经验:
- 判据用像素一致而不是字节一致,无关紧要的元数据差异不该让等价性断言变脆。
- 对照实验要自控制。验证 mask 是否真在模型层起作用,用「反转 mask 看两侧角色是否对调」,比「不传 mask 做对照」稳得多——后者依赖基准图内容,换一张图结论就翻转。
- 等价性要能证伪。「去背景等于改图加同一句指令」这个结论,是先证工作流逐字节相同、再证输出像素一致之后才下的。
最后:交付形态
| 入口 | 启动方式 | 适合 |
|---|---|---|
| Web 工具箱(推荐) | 双击 start_api.bat | 日常出图,拖拽上传、真实进度条 |
| OpenAI 兼容 API | 与 Web 界面同一服务 | 让程序 / Agent 框架调用本机出图 |
| 桌面图形界面 | 已退役,legacy 目录可跑 | 需要完全离线的本地 9B 改写器档位 |
到这里,这套东西算稳定下来了:8GB 显存的笔记本跑 Qwen-Image 2.1,上篇解决了「能不能跑」,下篇解决了「怎么被人和程序舒服地用」。下一个值得试的方向,是让 Agent 拿着这套 API 自己出图。
DISCUSSION
留言
正在加载留言…