FIELD NOTE
8GB 显存跑 Qwen-Image 2.1:ComfyUI 升级与四类工作流实测
在 RTX 5060 Laptop 8GB 上把 ComfyUI 从 v0.34.0 升到 v0.39.2,实测 Qwen-Image 2.1 的文生图、图改图、去背景和中文文字渲染,附完整性能基准和参数选型建议。
字号
文章字号:当前标准档正文宽度
上个月还在抱怨本地小模型降智,这个月换了方向:图像生成交给 ComfyUI + Qwen-Image 2.1,机器是一台 RTX 5060 Laptop,显存只有 8GB。官方工作流拉下来直接报节点缺失,从排查升级失败开始,到四类工作流全部跑通、把性能基准测了个遍,中间踩的坑和测出来的数据都值得记下来。
先自证一下能力:本文封面就是用文内这套工作流在本地直出的,包括「8GB 显存跑大模型」那两行字——标题文字也是模型渲染的,逐字核对无错字,1536² / 50 步一张过。
这篇按实际顺序写:先说升级为什么卡住、怎么解的,再列基准测试数据,然后逐个过工作流,最后是提示词改写器的本地/API 之争和最终的参数选型。所有耗时都在这台 8GB 机器上实测,换硬件结论要重新验证。
升级卡在 v0.34.0:根因是 PyPI 瞬时超时
官方 Qwen-Image 2.1 工作流打不开,提示 TextEncodeQwenImage21 节点未注册。这个节点是 v0.39.x 才有的,而 ComfyUI Desktop 的引擎停在 v0.34.0,且连续三次自动升级都失败。
比对 git 历史和三个残留的 backup_branch 之后,失败链条很清晰:
- Desktop 触发更新,源码成功切到 v0.39.2;
- uv 安装依赖时需要从 pypi.org 拉一个约 90MB 的模板包;
- PyPI 超时,
requirements install exited with code 2; - 事务保护机制判定「更新中断」,自动回滚源码到 v0.34.0。
三次失败都卡在第 3 步。有意思的是诊断时发现网络本身没问题:pypi.org 实测下载速度 8.5 MB/s,完整依赖解析只要 0.6 秒。也就是说这不是持续性封锁,只是三次都碰上了瞬时抖动,而事务回滚让每次抖动都前功尽弃。
解法分两步。先预热 uv 全局缓存——用一个临时 venv 把 v0.39.2 需要的 6 个包装进去,让重跑更新器时输出从「Would download 6 packages」变成无下载项,等于把网络依赖消掉了。然后建回滚分支、git checkout v0.39.2 --detach、离线重装依赖,57.6 秒完成,后端 6 秒就绪,目标节点注册成功。
一个容易踩的诊断陷阱
判断某个节点是否注册,直觉是查 ComfyUI 的接口:
$r = Invoke-WebRequest "http://127.0.0.1:8188/object_info/TextEncodeQwenImage21"但这个接口对不存在的节点同样返回 HTTP 200,响应体是空的 {}。只看状态码会永远得出「存在」的结论。必须检查响应体长度:
if ($r.Content.Trim().Length -le 2) { "节点不存在" } else { "节点存在" }我在这个判断上绕了一圈才反应过来,记在这里省得下次再踩。
模型下载:26.9GB 和两个教训
模型清单如下,全部来自 HuggingFace 的 Comfy-Org/Qwen-Image-2.1:
| 文件 | 目录 | 大小 |
|---|---|---|
| qwen_image_2.1_int8_convrot.safetensors | diffusion_models/ | 6.76 GB |
| qwen3vl_8b_int8_convrot.safetensors | text_encoders/ | 8.71 GB |
| qwen3.5_9b_..._pe_t2i.int8_convrot.safetensors | text_encoders/ | 8.82 GB |
| qwen_image_2.1_vae_bf16.safetensors | vae/ | 0.63 GB |
每个文件都做了 safetensors 头部校验——读前 8 字节作为小端整数,确认它是合法的 header 长度,再比对 header 声明的数据段长度和文件实际长度。这个校验能确定性地发现损坏文件,比看文件大小靠谱。
第一版下载脚本翻过车,两个教训:
- curl 的
--next陷阱:--next之后必须为每个 URL 重新指定-o,否则 curl 会把二进制写到终端,还会复用已用过的 range 参数。我因此拿到 3 个只有 137KB 的 HTML 错误页。 - 断点续传会污染文件:如果文件内容是 HTML 错误页,再用
curl -C -续传会把二进制追加在 HTML 后面,产生无法修复的损坏文件,必须删掉重下。
可靠做法反而很朴素:每个文件用独立的 curl 调用,主源失败换镜像,下载完跑一遍头部校验。
性能基准:数据比直觉诚实
测试条件统一为 1024²、euler 采样器、simple 调度器、cfg=1、种子固定,每次只改一个变量。
冷热差距和结果缓存:冷启动(含模型加载)约 30 秒,热缓存后稳定在 25.5 秒。最实用的是结果缓存——相同种子重复提交只要 1.07 秒。调参阶段固定种子反复提交几乎零成本,定稿后再换种子,这是这次实测里性价比最高的工作习惯。
步数-耗时(1024²):
| 步数 | 耗时 | 效果 |
|---|---|---|
| 5 | 6.1 秒 | 欠采样,暗且糊 |
| 15 | 16.2 秒 | 已可用,细节偏软 |
| 25 | 25.5 秒 | 质量到位 |
| 50 | 49.9 秒 | 细节最完整 |
线性拟合下来每步约 0.93~0.98 秒,固定开销(文本编码 + VAE 解码)只有约 1.5 秒。采样占了 25.5 秒里的 82%,没什么可优化的固定成本。
分辨率-耗时(25 步)才是重点:
| 分辨率 | 耗时 | 相对成本 |
|---|---|---|
| 1024² | 29.5 秒 | 1.0× |
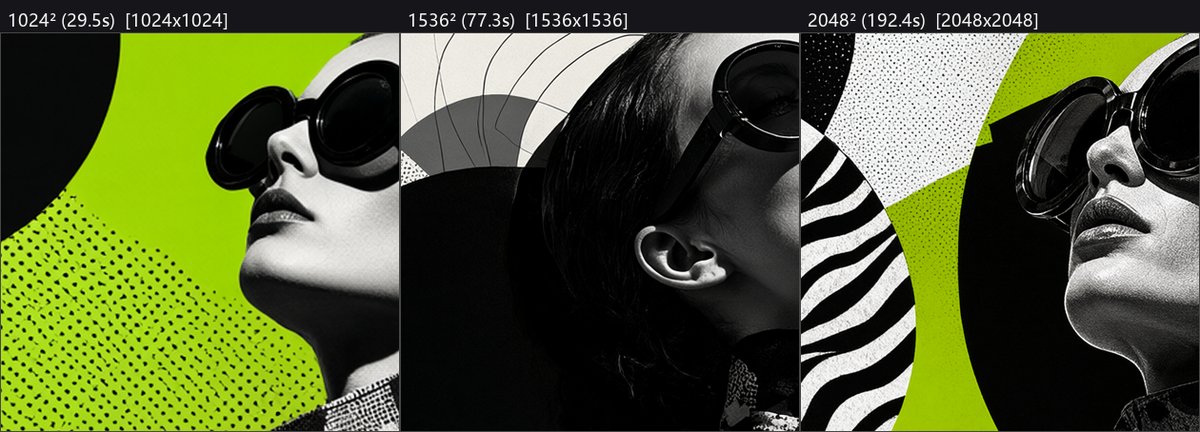
| 1536² | 77.3 秒 | 2.6× |
| 2048² | 192.4 秒 | 6.5× |
成本增长远超像素量,注意力计算的 O(n²) 在这里体现得明明白白。2048² 时显存峰值 7392 MiB,余量只剩约 640 MiB,是 8GB 卡跑原生 2K 的硬边界,靠 32GB 系统内存兜住的。
两个推翻直觉的结论:
一是分辨率对细节的提升远大于步数。1024² 从 25 步加到 50 步,耗时翻倍但细节提升有限;提到 1536²/2048²,半调网点这类细节是数量级的差别。同样想提升质量,钱该花在分辨率上。
二是没有优化空间了。对 50 步生成过程按 0.5 秒间隔采样显存,全程稳定驻留在 7206~7295 MiB,波动仅约 90 MiB——权重没有反复换入换出。这意味着换 fp16/fp8 权重存储不会加速,--fast-disk、--vram-headroom 这类参数也无效。0.93 秒/步就是这块 8GB 卡跑 1024² 的真实算力上限。
采样器也对比过:euler/simple 每步 0.93 秒,res_multistep 和 dpmpp_2m 约 1.05 秒,差异无实质意义。但 cfg=1 时换采样器等于换 sigma 轨迹,会得到完全不同的构图,不是同一张图的变体。所以结论是保持 euler,纯靠步数和分辨率控制质量。
四类工作流实测
文生图
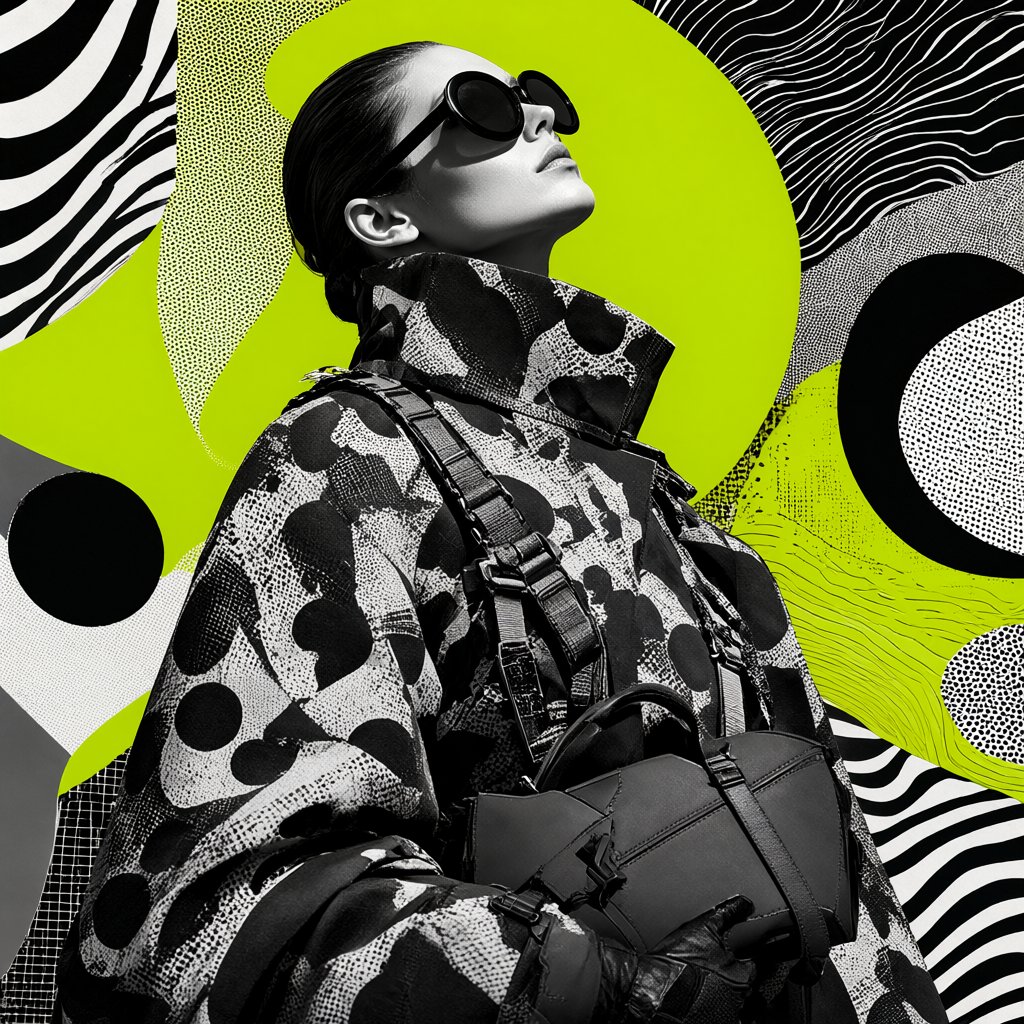
1024² / 25 步,25.5 秒出图。有个改 JSON 时容易踩的键名错位:模板 JSON 里 scheduler 键对应的界面标签是 sampler(采样器),scheduler_1 才是真正的调度器,对错位时会发现参数「不生效」。
图改图与多参考图
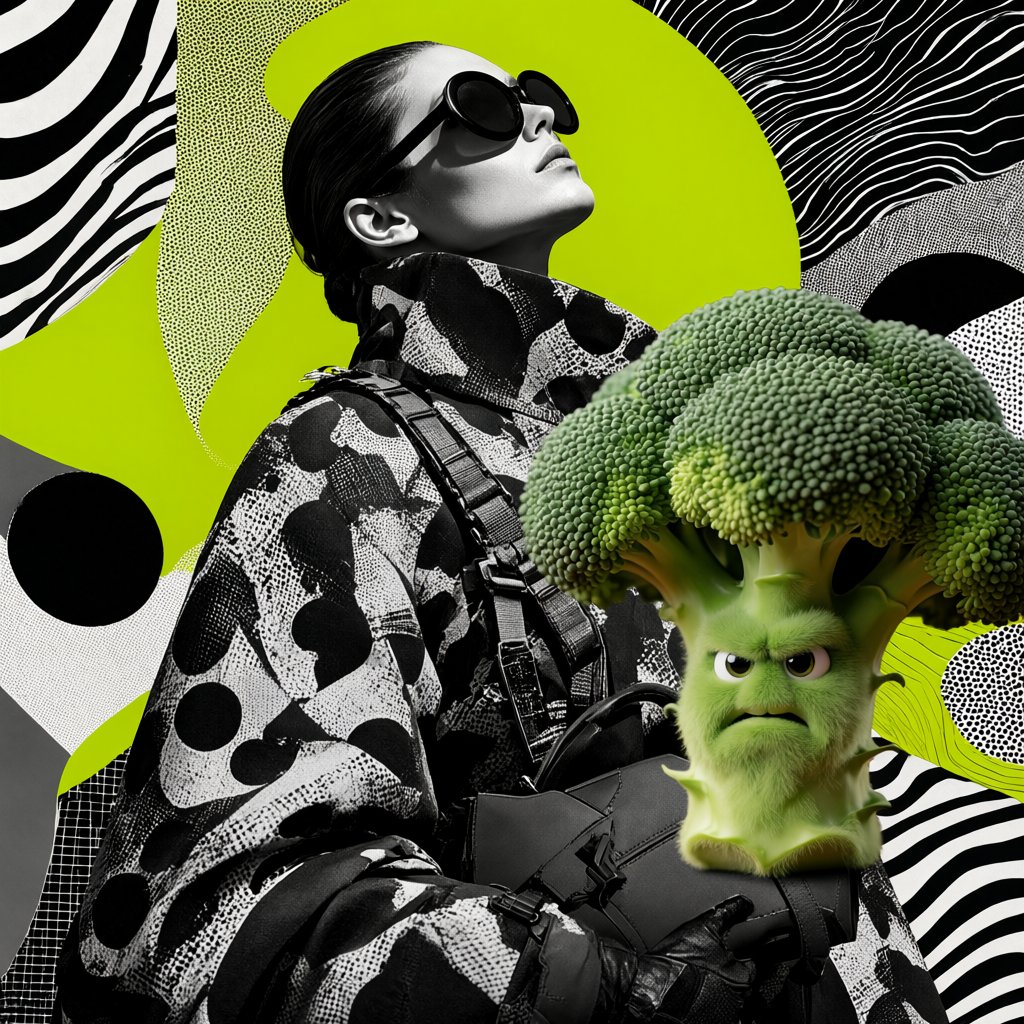
把背景从青柠绿改成深绯红渐变,主体姿态、墨镜、服装图案全部保留,45.4 秒。多参考图实测支持 16 个槽位(超过官方文档写的 10 张),每增 1 张参考图约 +16 秒(1024² 的 VAE 编码),采样部分不变,成本完全可预测。
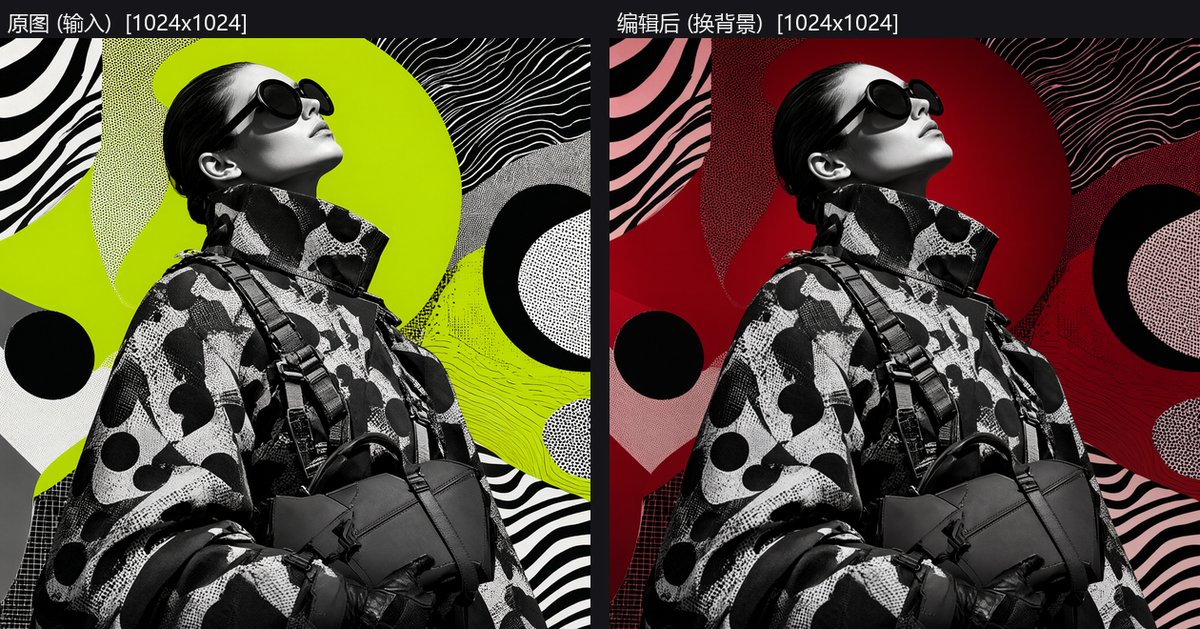
两个要知道的边界:
resolution参数是总像素预算而非宽高,0 表示不缩放;- 参考主体的固有颜色不会被风格化。即使提示词明确要求匹配参考图 1 的黑白半调风格,参考图里的物体始终保留彩色——Qwen 把参考图作为结构化内容(形状、姿势、物体身份)注入,不是可覆盖的风格层。想改颜色要显式写「recolor to pure grayscale」这类指令,或者拼合后再加一步全图去色。
去背景
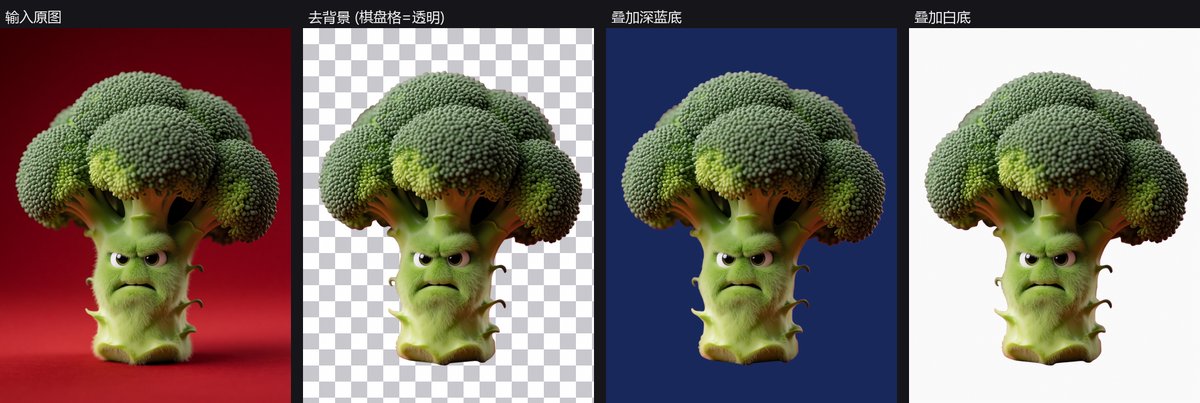
提示词只要一句:Remove the background, and output a PNG image。896×1152 输入,47 秒输出同尺寸 RGBA。alpha 通道统计里 48.1% 是半透明像素——软边缘羽化,所以叠到深蓝底和白底上都无白边、无绿边污染,连花球颗粒间的细缝都正确分离了。
有个发现值得单独说:去背景和图改图共用完全相同的 Image Edit 子图,抠图不是独立模型,而是一条编辑指令。耗时也印证了这一点(45.4s vs 47.0s)。Qwen-Image 2.1 的编辑能力是统一建模的。
中文文字渲染
这是最惊喜的部分。1024² / 50 步,四组测试全部通过 1:1 特写逐字核对:
| 测试 | 内容 | 耗时 | 结果 |
|---|---|---|---|
| T1 | 中文短标题「人工智能」 | 56.1 秒 | 笔画完全正确 |
| T2 | 英文 COMFY STUDIO | 53.1 秒 | 拼写零错误 |
| T3 | 中文密集海报(9 个文字块) | 52.9 秒 | 全部逐字正确 |
| T4 | 中英混排咖啡包装(6 个文字块) | 53.0 秒 | 全部逐字正确 |
T3 的海报包含「城市光影艺术节」「二零二五年度特别企划」「时间:十月一日至十月三十日」等 9 个文字块,零错字、零漏字、零幻觉。扩散模型做文字渲染最容易翻车的就是字符数,这里完全没出问题。而且中文密集排版反而比英文短标题更干净,中文原生优化的成色很足。
另外耗时和文字量无关——306 字提示词 56.1 秒,822 字 53.0 秒,多写描述不加成本。
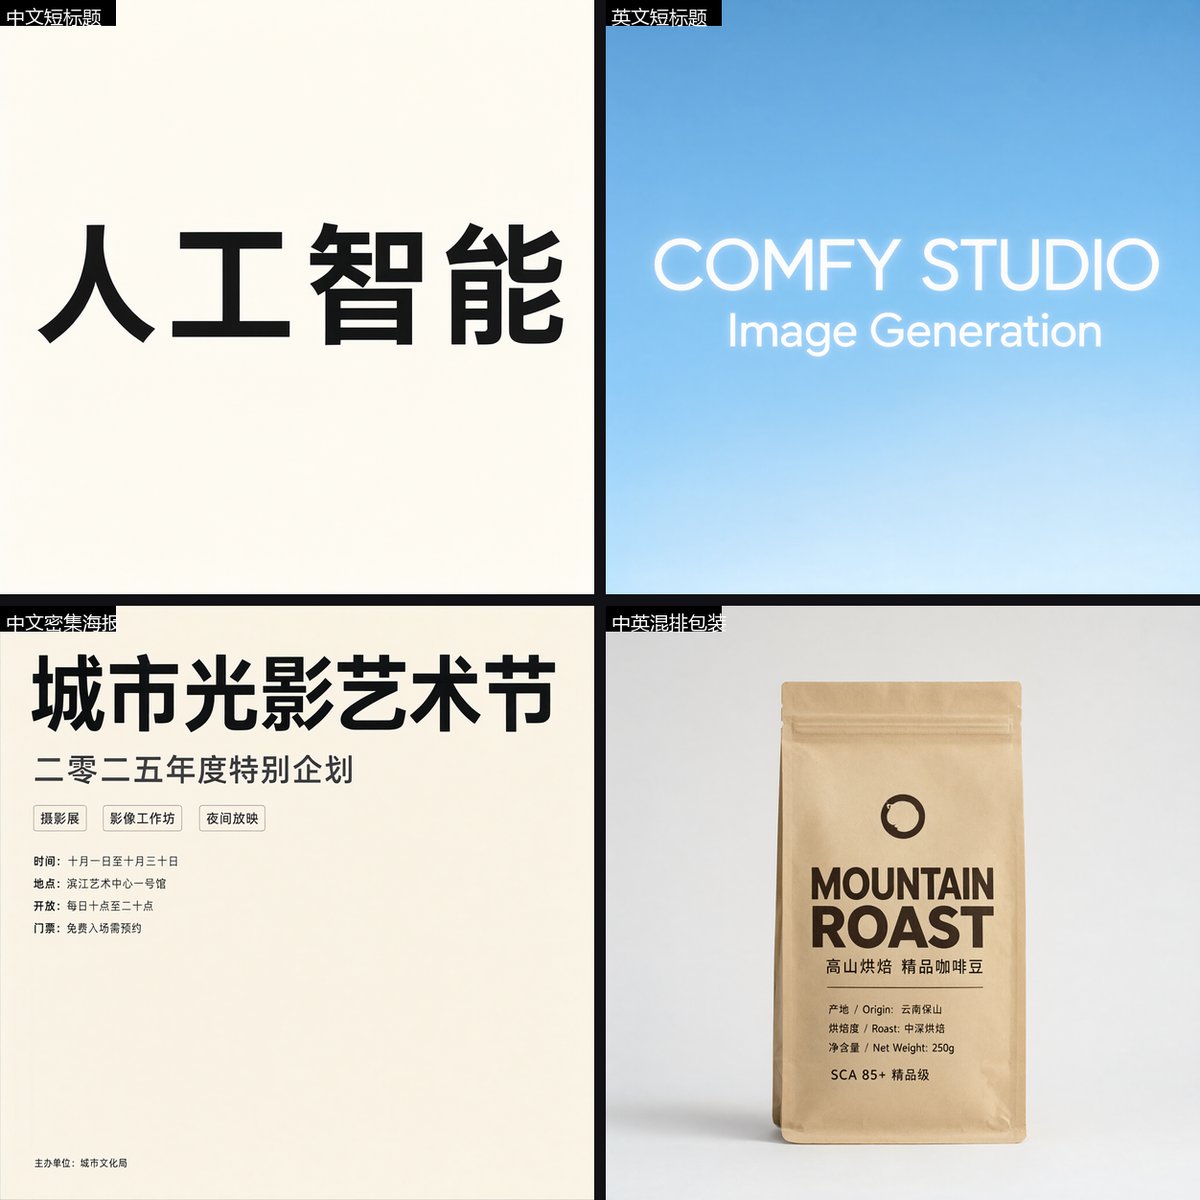
测试边界也要诚实说:每种场景只测了 1 个种子且都是 1024²,不能保证所有种子都成功;极小字号有风险;没测过整段文章级别的超长文本。
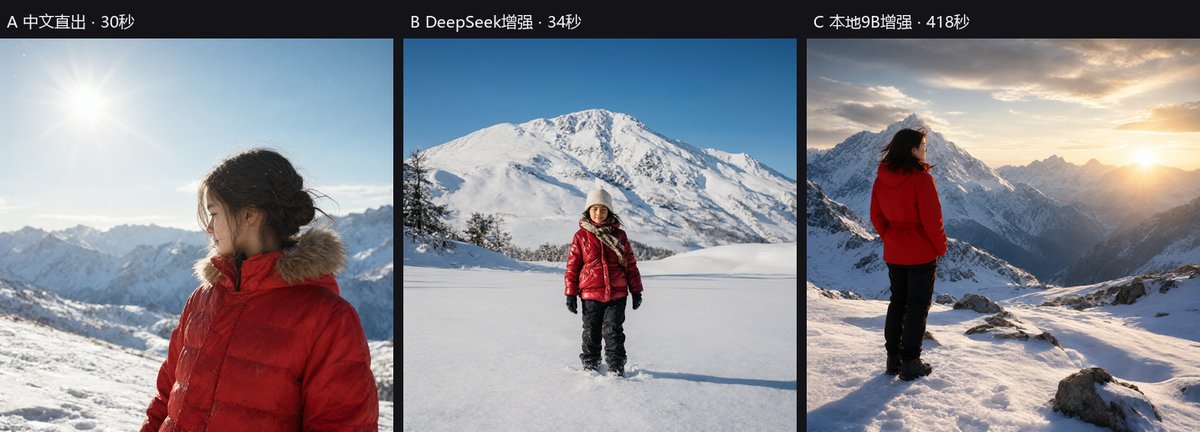
提示词改写器:本地 9B 不如外部 API
官方模板里藏着一个默认关闭的提示词改写器(refine_prompt 开关):用一个 8.82GB 的 9B 模型把口语化需求翻译成精确的英文视觉描述。比如「电影感」这种模糊词,会被翻译成构图站位、光线时刻、配色关系等几十个可执行的决策——这才是质量提升的真正来源。
但本地 9B 档的代价很难接受:
| 方案 | 端到端耗时 | 锐度指标 | 额外代价 |
|---|---|---|---|
| 不增强(中文直出) | 30.3 秒 | 232 | 无 |
| 本地 9B 改写 | 417.6 秒 | 446 | 8.82GB 模型常驻 |
| API 改写(DeepSeek) | 34.1 秒 | 349 | 约 0.002 元/次 |
本地档 417.6 秒里约 387 秒花在改写环节,端到端慢了 13.8 倍,只换来比 API 档略高的锐度。改写本质是纯文本任务,不需要多模态能力,所以从官方模板提取系统提示词交给外部 API 执行同样的改写,端到端只要 34.1 秒,快约 12 倍,还省下 8.82GB 下载和常驻内存。代价是偶发小幻觉(多画了没要求的小元素)和网络依赖。
还有个坑:t2i 和 i2i 两套系统提示词对输出语言的要求完全相反。t2i 规定无论输入什么语言都输出英文;i2i 则是中文输入输出中文描述,且「要画进图里的文字」必须保留原语言。实测输入「把海报标题改成"夏日特惠"」,改写结果完整保留了这四个字未被翻译。所以 i2i 输出中文是正确行为,不是缺陷。
最终选型
把基准数据折算成档位建议(RTX 5060 Laptop 8GB):
| 用途 | 分辨率 / 步数 | 耗时 |
|---|---|---|
| 快速试构图、调提示词 | 1024² / 25 步 | 约 30 秒 |
| 日常出图 | 1536² / 30 步 | 约 91 秒 |
| 追求细节的终稿 | 2048² / 40 步 | 约 302 秒 |
| 图改图(每张参考图 +16 秒) | 1024² / 25 步 | 约 45 秒 |
| 去背景 | 1024² / 25 步 | 约 47 秒 |
| 文字密集海报 | 1024² / 50 步 | 约 53 秒 |
总结成几句话:想提升质量优先加分辨率而不是步数;采样器保持 euler 别动;调参阶段固定种子利用结果缓存;提示词改写用外部 API,本地 9B 档在 8GB 卡上性价比太低;中文文字渲染可以放心交给 Qwen-Image 2.1,小字场景记得把分辨率提到 1536² 以上。
还没做的验证:多种子稳定性统计、2048² 下包装成分表级小字的清晰度边界。这几个留到下次有整块时间再测。
DISCUSSION
留言
正在加载留言…